Aaronnys Ortiz

Desarrollador Qlik Sense · Inteligencia de Negocios

Aaronnys Saúl Ortiz Molina

Trabajo en Inteligencia de Negocios del Grupo DAABON, un grupo agroindustrial de 53 sociedades: plantaciones, plantas extractoras, una refinería, una zona franca y operación portuaria.

Tengo 23 informes de Qlik Sense a mi cargo. Los mantengo, los optimizo y respondo por sus números — que es distinto de haberlos hecho una vez.

Santa Marta, Colombia · UTC−5 · Español nativo · Inglés B2 (sin certificación)

23
informes de Qlik Sense a mi cargo, todos versionados en Git
414 → 279 s
recarga de la app más grande, con cada paso verificado
8 → 3
claves sintéticas en esa misma app
~4 años
de experiencia en datos y desarrollo

Proyecto propio

RESUMEN — Una app de Qlik Sense construida entera, de la carga al tablero

No puedo enseñar mis tableros de trabajo: llevan clientes, nómina y valores en aduana. Así que construí uno nuevo, con datos completamente inventados, sobre una comercializadora agroexportadora ficticia.

Todo lo que se ve abajo son capturas de Qlik Sense de verdad, no maquetas: 235.000 filas, un modelo en estrella sin una sola clave sintética, y cuatro hojas. El script, el modelo y la definición de cada objeto están en el repositorio.

Datos232.000 líneas de factura + 26.000 de presupuesto, generadas con AutoGenerate
ModeloEstrella: 1 hecho, 5 dimensiones, calendario maestro. 0 claves sintéticas, 0 lazos circulares
Recarga~6 segundos
ConstrucciónScript, variables, hojas y objetos creados por Engine API desde Node.js, no a mano
Resumen comercial — captura de Qlik Sense

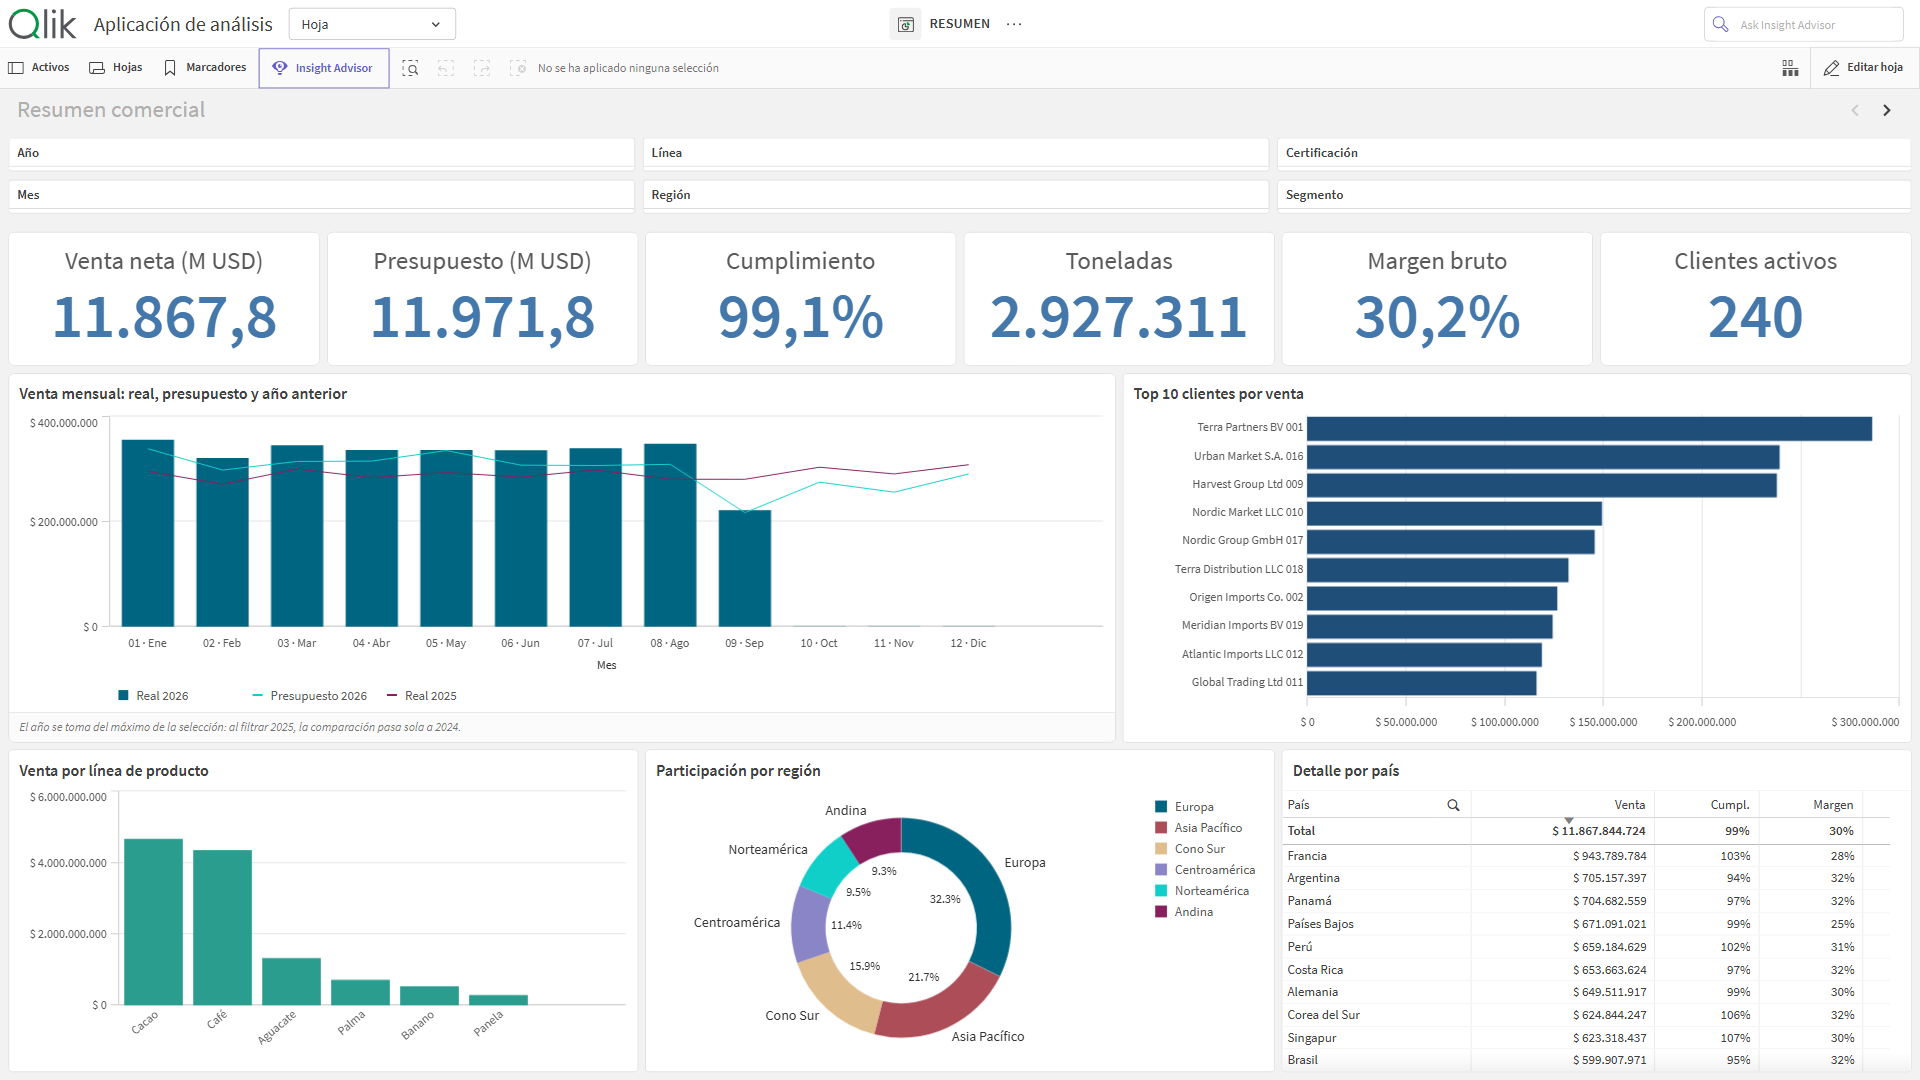
Resumen comercial

La hoja que se abre primero: seis KPI, la serie mensual contra presupuesto y contra el año anterior, y el detalle por país.

  • El gráfico mensual no tiene el año escrito en ninguna parte: lo toma de $(=Max(Anio)). Al filtrar 2025, la comparación pasa sola a 2024.
  • Los seis KPI salen de variables de app, no de expresiones copiadas en cada objeto. Corregir el margen se hace en un sitio.

Set analysis

// La barra: el año que mande la selección
Sum({<Origen={'Real'}, Anio={$(=Max(Anio))}>} Valor_USD)

// La línea de comparación: el año anterior a ese
Sum({<Origen={'Real'}, Anio={$(=Max(Anio)-1)}>} Valor_USD)
Presupuesto vs real — captura de Qlik Sense

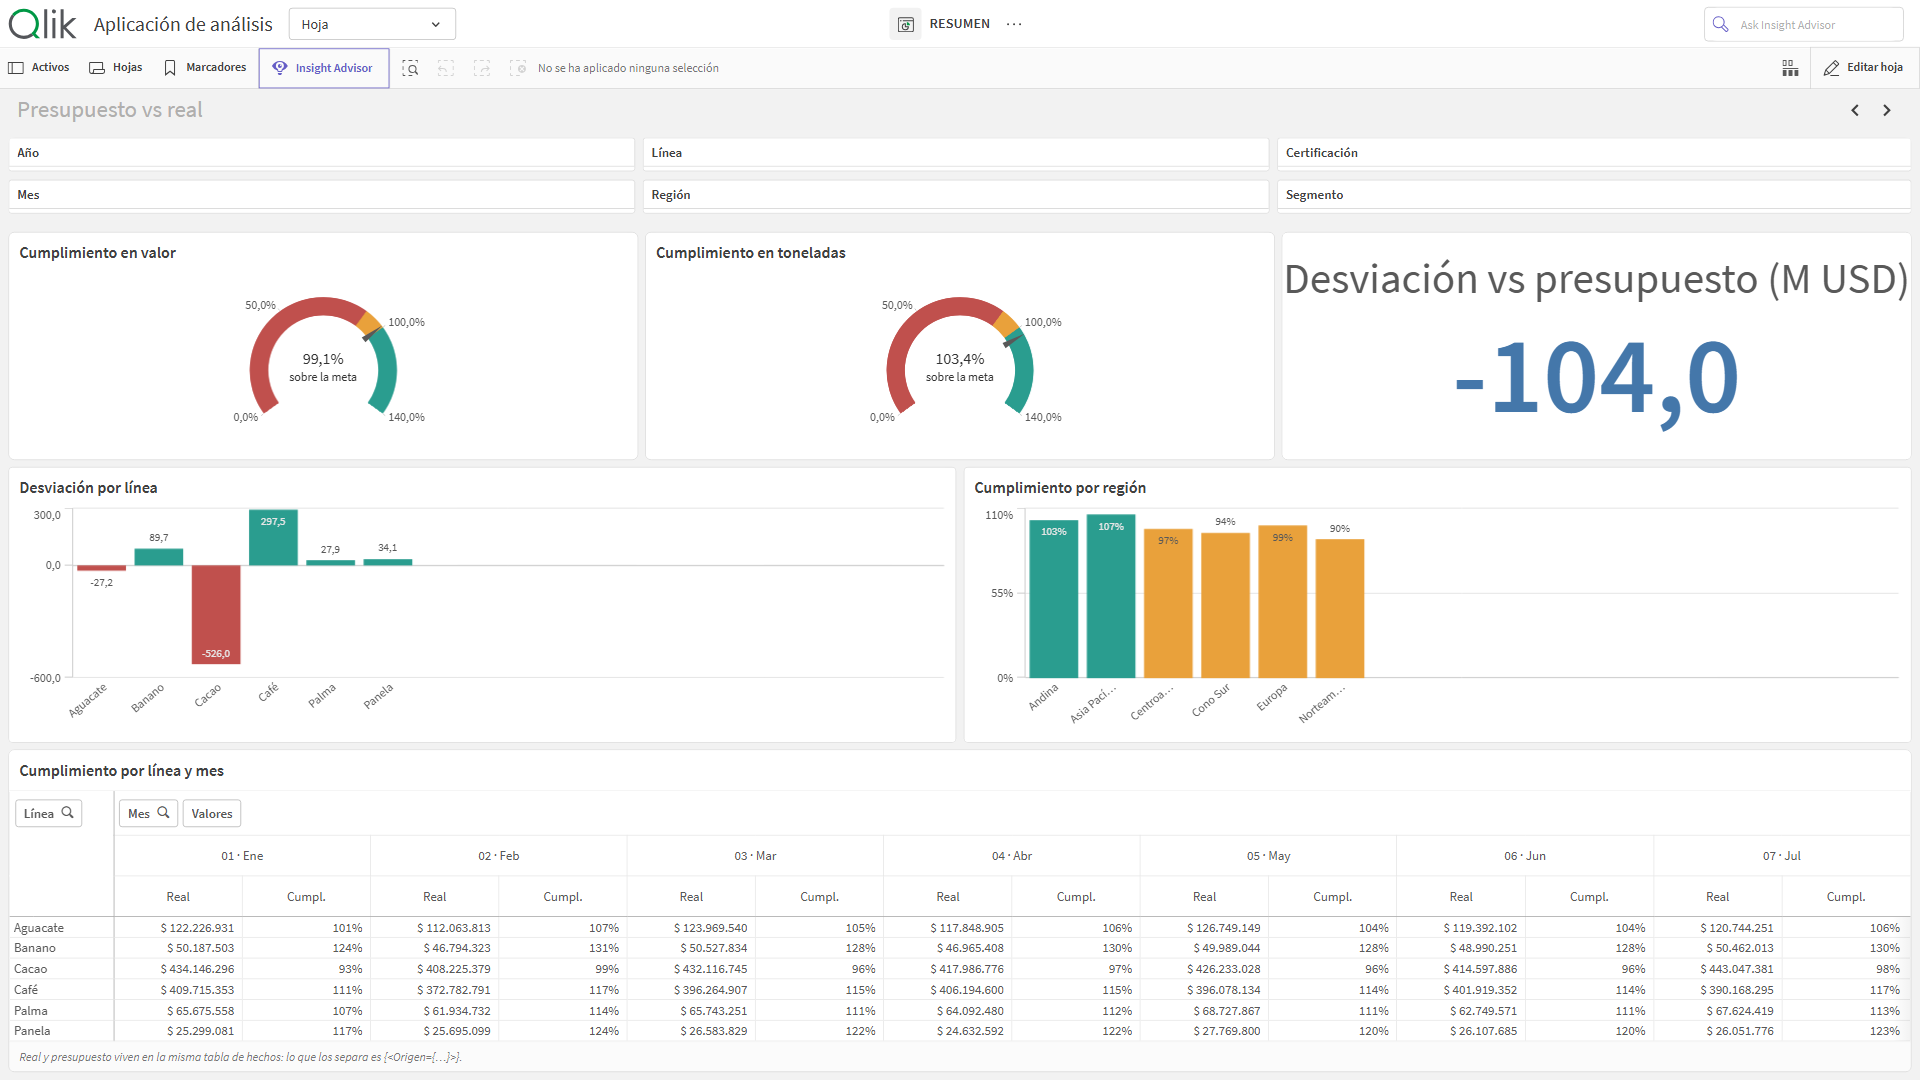
Presupuesto vs real

Cumplimiento en valor y en volumen, desviación por línea con color condicional, y la tabla dinámica de línea por mes.

  • Real y presupuesto viven en la misma tabla de hechos, concatenados con un campo Origen. Una tabla de presupuesto aparte con Año, Mes, Producto y País habría creado claves sintéticas contra el calendario, el producto y el país a la vez.
  • Lo único que separa los dos mundos es set analysis. Eso es lo que permite que el mismo filtro de Región mueva las dos cifras.

Modelo + set analysis

// En el script: el presupuesto se concatena, no se une
CONCATENATE (Hechos_Comercial)
LOAD  %LlaveProducto, %LlavePais,
      Date(MakeDate(Anio_Ppto, Mes_Ppto, 1))  as Fecha,
      'Presupuesto'                           as Origen,
      ...

// En el tablero: lo que los separa
vVentaReal     = (Sum({<Origen={'Real'}>}        Valor_USD))
vVentaPpto     = (Sum({<Origen={'Presupuesto'}>} Valor_USD))
vCumplimiento  = ($(vVentaReal) / $(vVentaPpto))
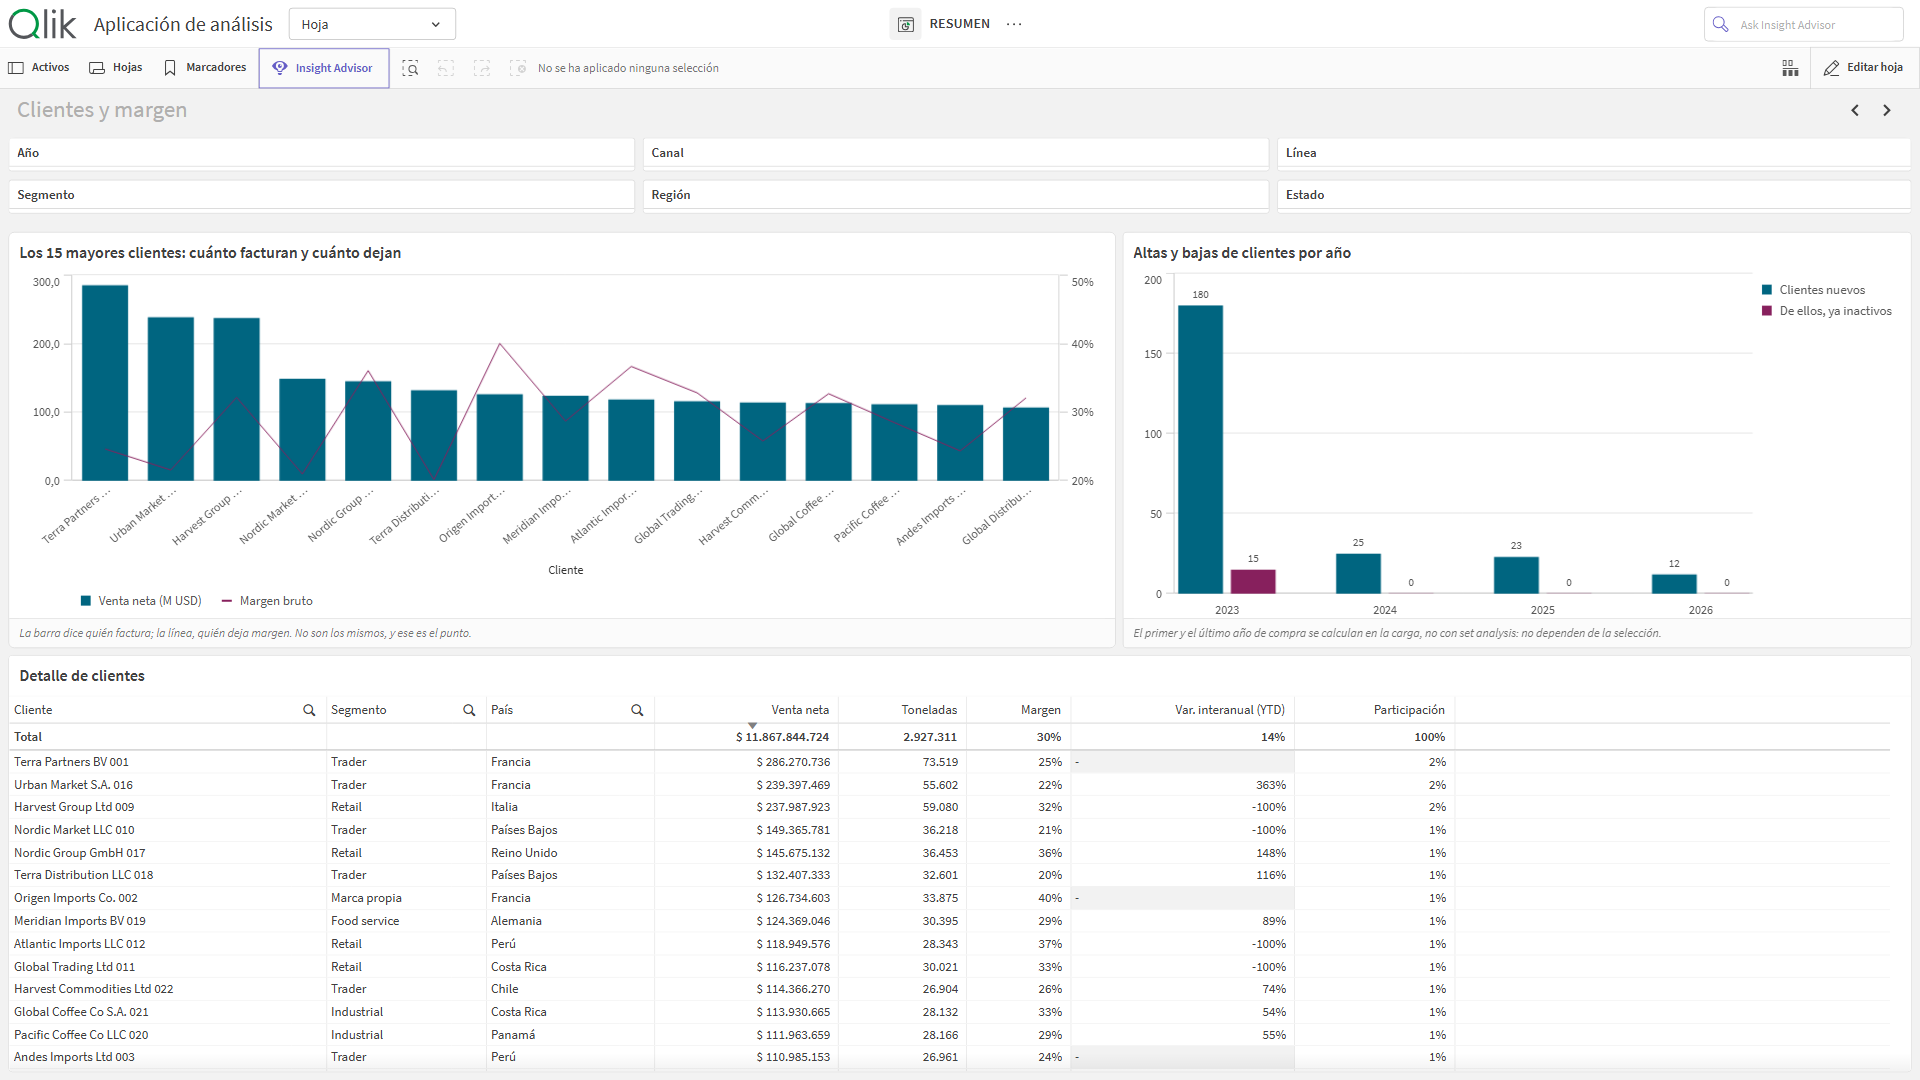
Clientes y margen — captura de Qlik Sense

Clientes y margen

Quién factura y quién deja margen — que no son los mismos —, las altas y bajas de cartera por año, y el detalle con variación interanual comparable.

  • La comparación interanual está recortada por el mismo mes de corte en los dos años. Comparar un año a septiembre contra otro completo inventa una caída del 25 % que no existe.
  • El primer y el último año de compra de cada cliente se calculan en la carga, no con set analysis: no dependen de la selección, así que no hay razón para recalcularlos en cada clic.

Script + variables

// En la carga: lo que no depende de la selección
LEFT JOIN (Clientes)
LOAD  %LlaveCliente,
      Min(Year(Fecha)) as Anio_Primera_Compra,
      Max(Year(Fecha)) as Anio_Ultima_Compra
RESIDENT Hechos_Comercial  WHERE Origen = 'Real'
GROUP BY %LlaveCliente;

// En el tablero: los dos lados recortados por igual
vVentaYTD          = (Sum({<Origen={'Real'}, Anio={$(=Max(Anio))},   Es_Mes_YTD={1}>} Valor_USD))
vVentaYTDAnterior  = (Sum({<Origen={'Real'}, Anio={$(=Max(Anio)-1)}, Es_Mes_YTD={1}>} Valor_USD))
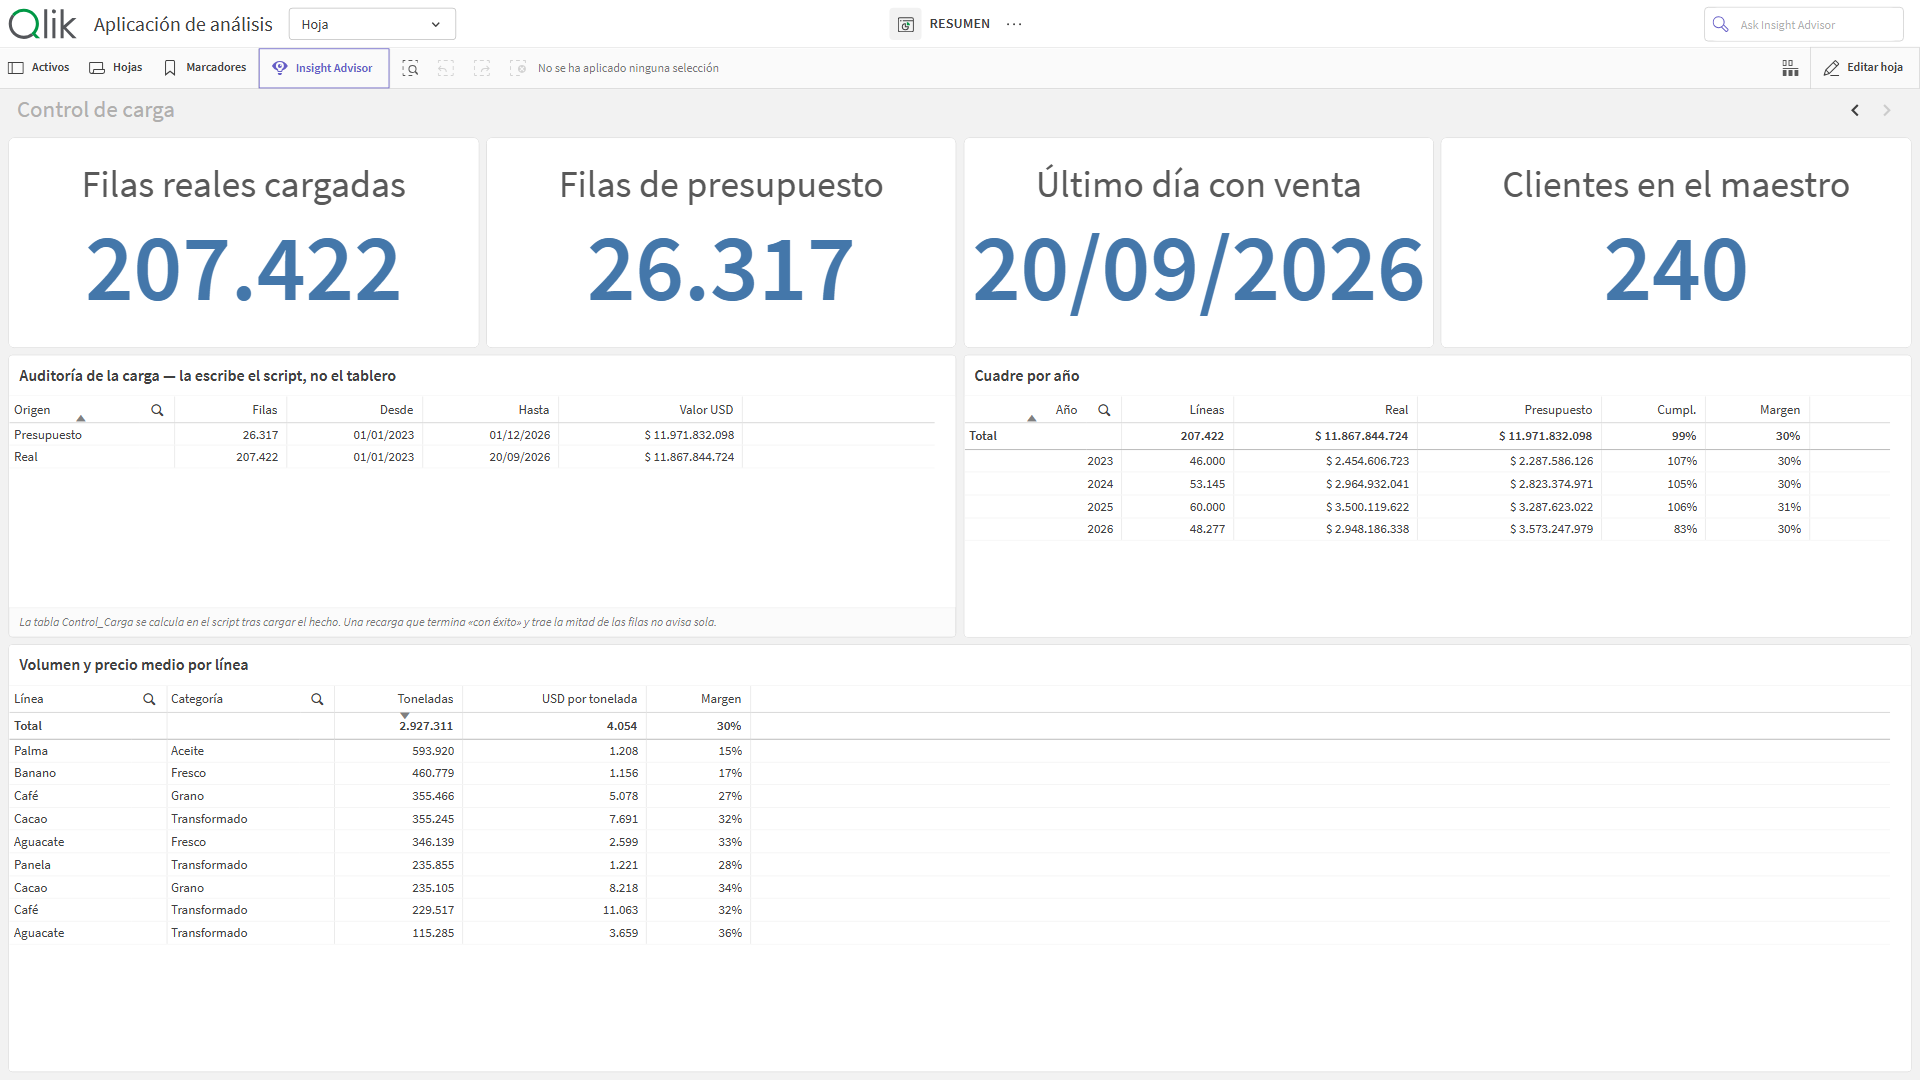
Control de carga — captura de Qlik Sense

Control de carga

La hoja que nadie mira mientras todo cuadra, y la primera que se abre el día que no.

  • La tabla de auditoría la escribe el script después de cargar el hecho: cuántas filas entraron de cada origen, de qué fecha a qué fecha y cuánto suman.
  • Una recarga que termina «con éxito» y trae la mitad de las filas no avisa sola. Esta hoja es lo que hace que se note en un minuto en vez de en una reunión.

Script

Control_Carga:
LOAD  Origen           as Control_Origen,
      Count(Origen)    as Control_Filas,
      Date(Min(Fecha)) as Control_Fecha_Min,
      Date(Max(Fecha)) as Control_Fecha_Max,
      Round(Sum(Valor_USD)) as Control_Valor_USD
RESIDENT Hechos_Comercial
GROUP BY Origen;
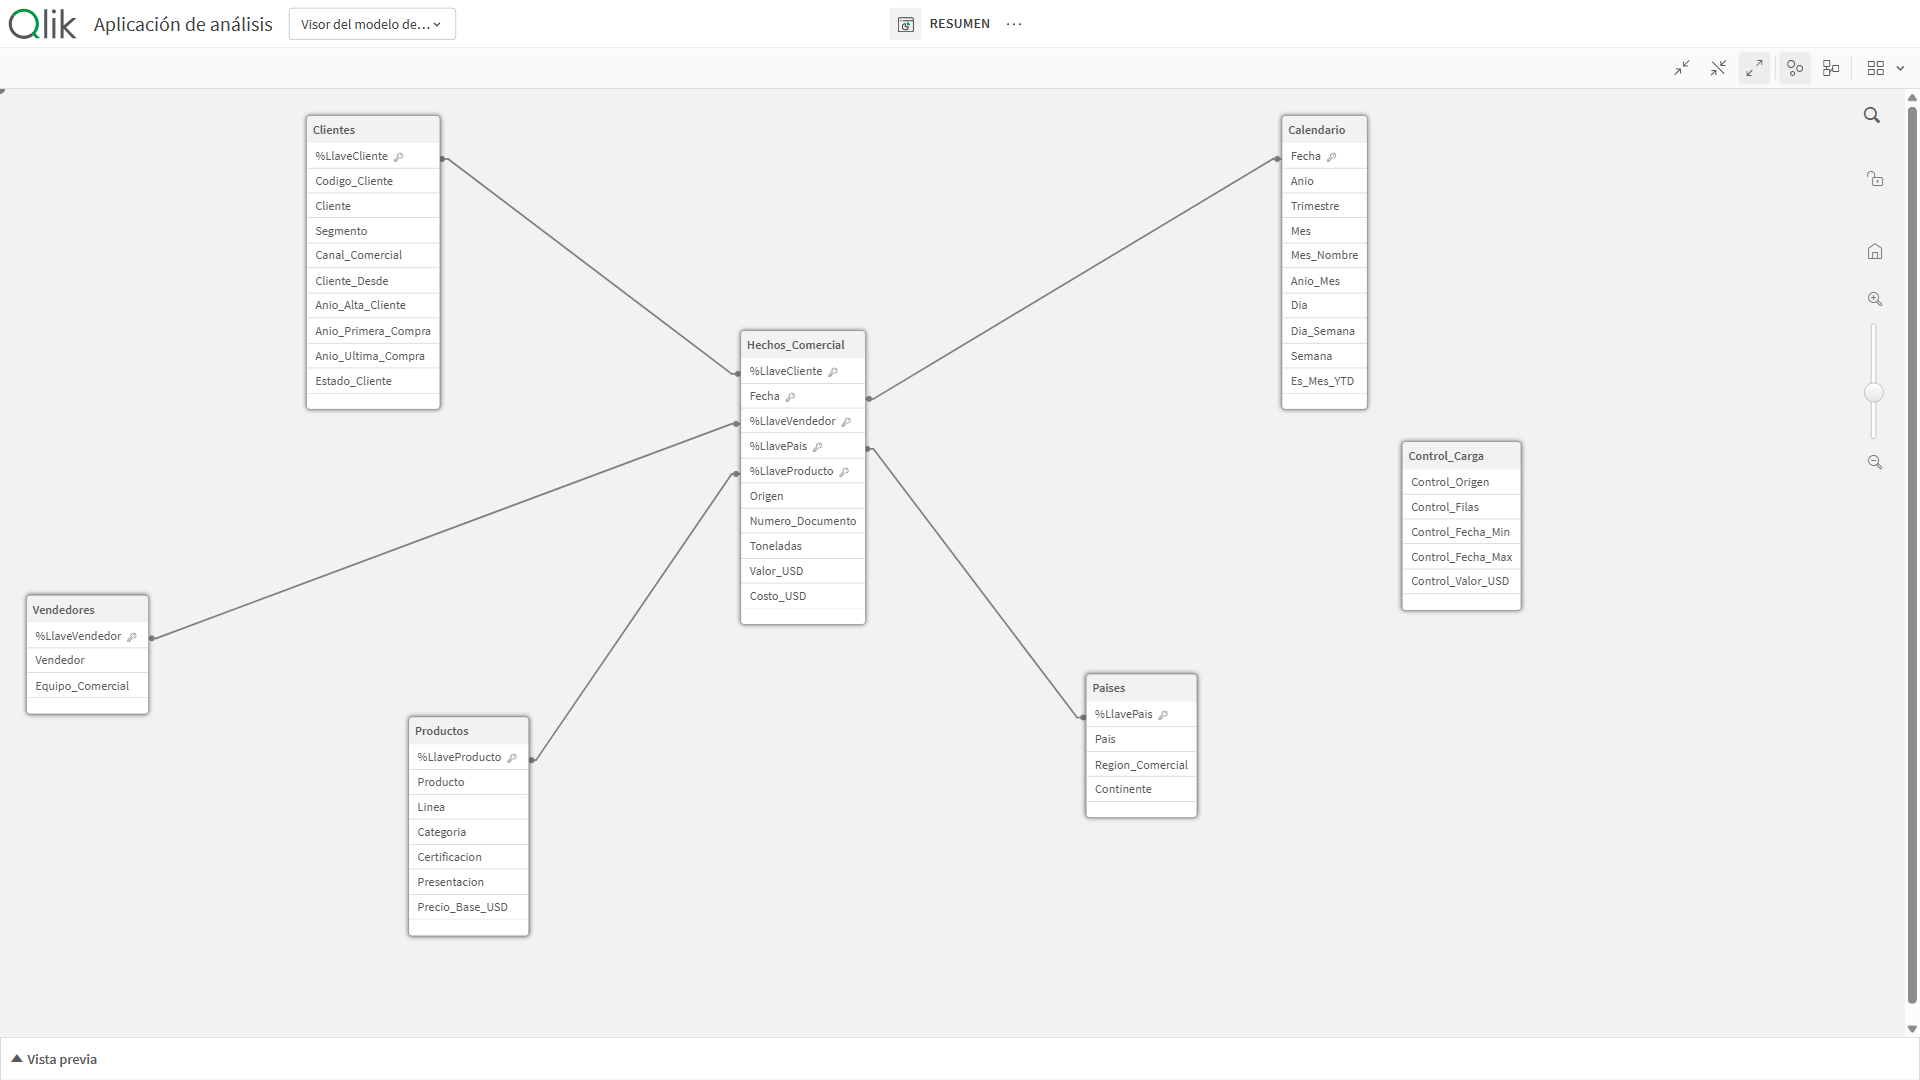
El modelo — captura de Qlik Sense

El modelo

El visor del modelo de datos de la propia app. Un hecho en el centro, cinco dimensiones y el calendario.

  • Un tablero vistoso se puede montar encima de un modelo desastroso. Esta captura es la que lo descarta: ninguna tabla $Syn, ningún lazo circular.
  • El país cuelga del hecho y no del cliente, a propósito. Si Paises colgara de Clientes y a la vez del hecho, el modelo cerraría un lazo. Se resuelve en la carga con ApplyMap.
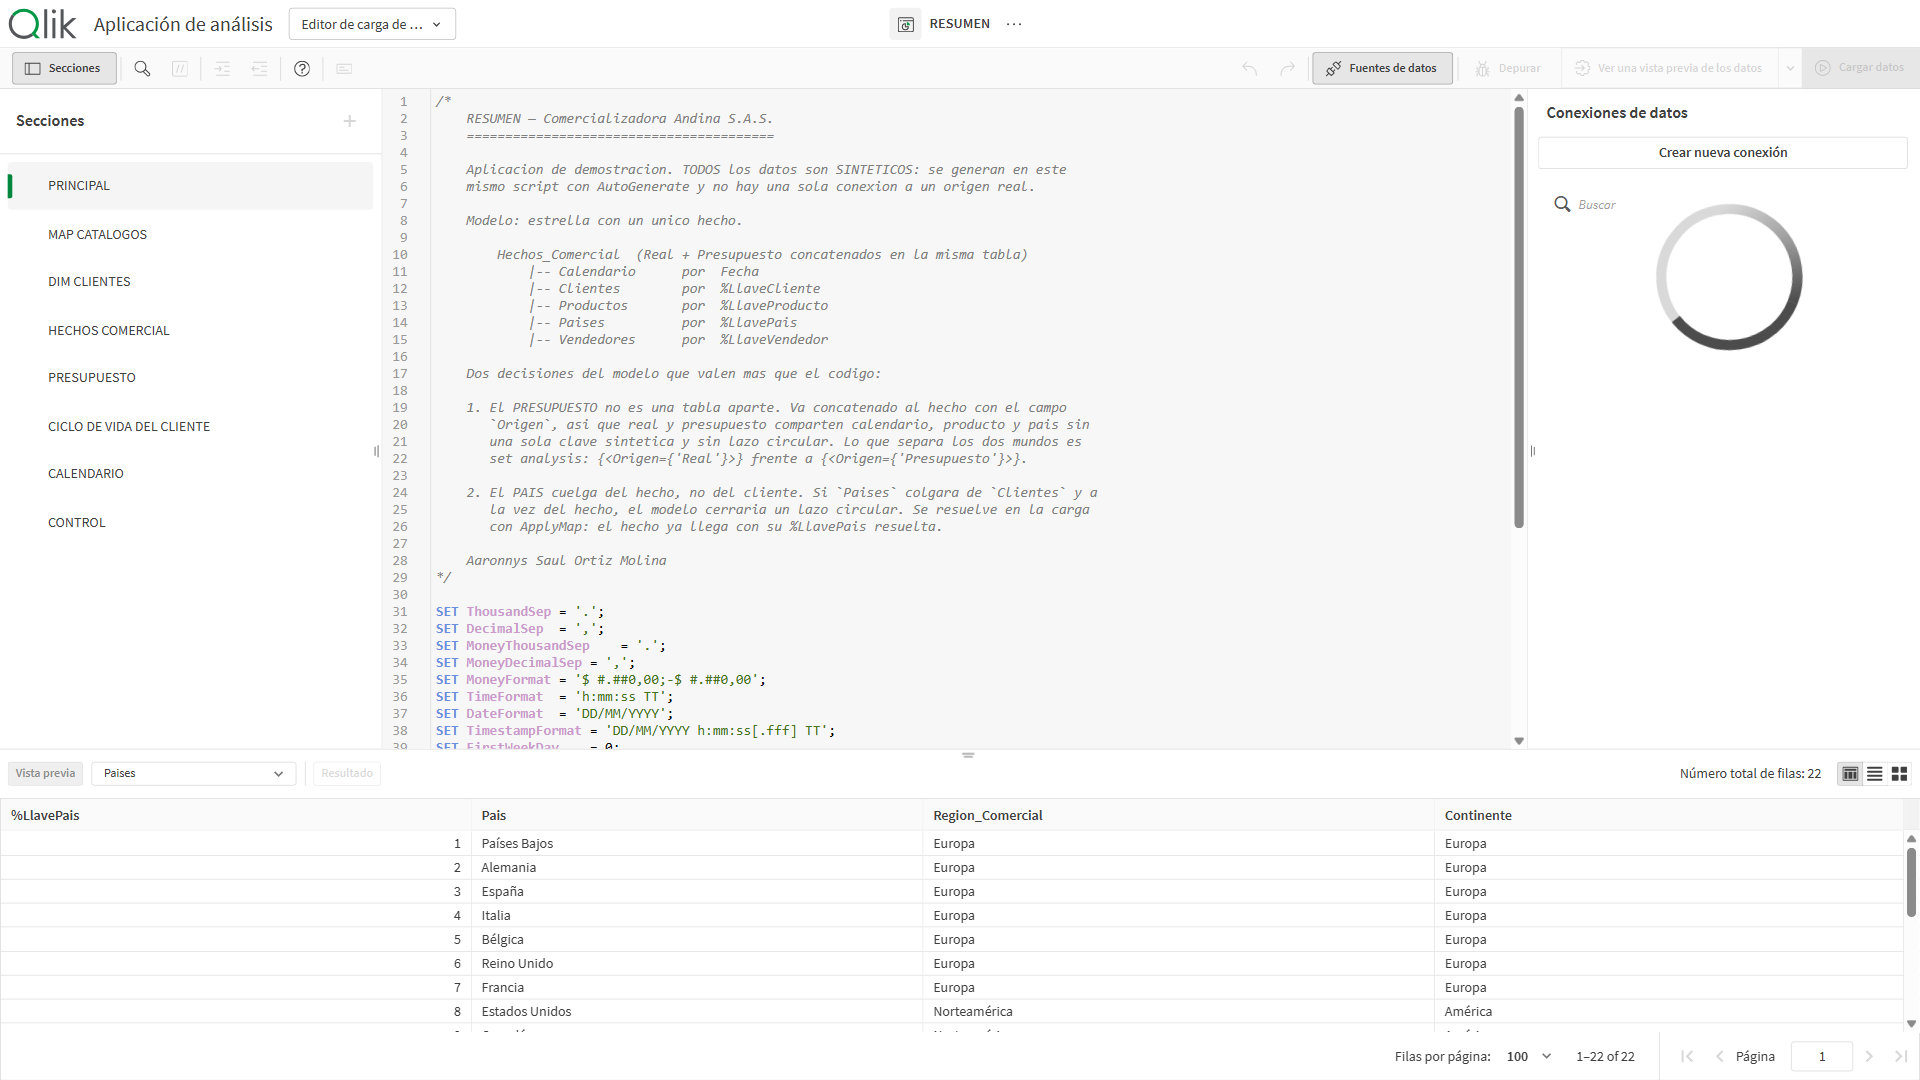
El script — captura de Qlik Sense

El script

Siete pestañas, separadas por origen y por tabla, con el porqué escrito arriba.

  • Los catálogos dejan su tabla de mapeo al cargarse; el hecho resuelve todo con ApplyMap y no necesita un solo JOIN.
  • Los comentarios no dicen lo que hace la línea, dicen por qué está. Los que vienen detrás —normalmente yo, tres meses después— no tienen que deducirlo del código.

Tres cosas que salieron mal construyéndola

Van aquí porque son lo más parecido a una entrevista técnica que cabe en una página. Las tres dieron resultados plausibles y falsos — ninguna dio error.

Una variable con coma decimal dentro de un Round()

Con DecimalSep = ',', un LET guarda 1,043 como texto. Al expandirla dentro de Round(precio * $(vDeriva) * ..., 0.01), la coma se lee como separador de argumentos. No dio error: dio precios de centavos, y solo se vio al sumar por año. La deriva pasó a calcularse como campo, no como variable.

Variables sin paréntesis

Una variable se expande como texto antes de evaluarse. $(vMargenBruto) / $(vVentaReal) se convertía en Sum(a) − Sum(b) / Sum(c), que por precedencia es otra cosa. El KPI mostraba un margen de 1.184.492.738.048 %. Ahora todas las definiciones van entre paréntesis.

Gráficos que el motor calcula y el cliente no pinta

Los gráficos de barras creados por API con propiedades mínimas devolvían el hipercubo correcto, con sus filas y sin un solo error, y se pintaban vacíos. La solución fue partir de un objeto real del servidor y sustituirle dimensiones y medidas. El scatterplot que quería para la hoja de clientes no se pudo: no existe ninguno en el servidor del que copiar la carcasa, así que lo cambié por un gráfico combinado que dice lo mismo.

Grupo DAABON · 53 sociedades

Seis cosas que arreglé y cómo lo comprobé

No hay capturas aquí: estos informes llevan clientes, nómina y valores en aduana. Lo que sí hay son los números de antes y de después, que es lo que se puede comprobar en una llamada.

Optimizar la app más grande sin cambiar un solo número

Once dominios de negocio conviviendo en una sola app —P&G, costos, ventas, cartera, dos zonas francas, logística, ausentismo, PQRS y CRM—. 6.210 líneas de script en 39 pestañas, 37 hojas, 708 objetos. No se diseñó: se fue apilando.

414 → 279 s
tiempo de recarga
11,1 → 4,5 M
filas del modelo (−60 %)
8 → 3
claves sintéticas
60 → 37
consultas al ERP por recarga
  • Documenté la app entera antes de tocarla, incluidas sus 309 medidas. Sin eso, «optimizar» es adivinar.
  • Tomé una línea base de todas las medidas contra una copia sin tocar, y comparé después de cada paso. El resultado verificado: 309 de 334 medidas idénticas, 0 errores. Las 25 restantes se revisaron una a una.
  • Siete aperturas de un Excel compartido por recarga pasaron a cero, sustituidas por los QVD de una extractora. Antes de cambiarlo medí la trampa: los dos scripts leen las fechas con un SET DateFormat distinto y un QVD las guarda ya interpretadas; si una columna llegara como texto ambiguo, las llaves dejarían de casar sin dar ningún error. Comprobado hoja por hoja: las cinco idénticas.

De 15 hallazgos, seis arreglados. El último fue el que más dinero movió: al presupuesto de costos le faltaban 240.405 millones de pesos por dos errores encadenados —un Left Join que multiplicaba filas y un LOAD DISTINCT que colapsaba líneas—. Se cuadró contra los QVD de origen leídos directamente.

Lo que hay que decir antes de que lo preguntenLas tres claves sintéticas que quedan no son descuido: están sosteniendo defectos de datos de otros sistemas. Resolverlas cambia cifras que alguien mira, así que están documentadas y esperando decisión, no arregladas a escondidas.

Un informe que nunca había logrado recargar

Una app de Desarrollo Humano publicada, que gerencia consultaba, con datos congelados de tres semanas atrás. La recarga manual moría a los 261 segundos y nadie sabía por qué.

1 columna
era la causa
325 s
recarga completa, después
387 M
filas leídas
192
expresiones sin error
  • Dos pestañas pedían las 39 columnas de una vista del ERP. Una de ellas cuelga la consulta indefinidamente. Pedir solo las 8 columnas que el LOAD usaba fue todo el arreglo.
  • Detrás aparecieron seis errores más, todos medidos: una lista de festivos que no surtía efecto (4.261 → 3.938 personas fuera de meta), dos rangos sin tramo que dejaban 635 personas en nulo, una sociedad sin grupo asignado (3.647 → 4.887 en Cultivo) y una columna vacía.

Cada corrección quedó registrada con el número de antes y el de después. Incluido un diagnóstico mío que resultó equivocado, corregido en el mismo documento.

Lo que hay que decir antes de que lo preguntenEl informe sigue sin disparador por horario. Eso lo decide el administrador del entorno, no yo.

El archivo que se llamaba 2026 y traía 2025

Cuatro informes leen los QVD que deja una extractora. Buscando otra cosa, encontré que los archivos se solapaban.

70.058 filas
para 34.961 manifiestos
4
informes afectados
1
línea de la URL de origen
  • La URL del extractor hace aritmética con la fecha, y 2026-01-01 se evalúa como 2024. El rango que llega a la API es el de la conexión, no el que pide el script.
  • Consecuencia medida: dos informes tienen 2025 duplicado y otros dos reciben 2025 desde un archivo llamado 2026.

Está documentado con los números y sin tocar. Arreglarlo en el origen es una app publicada de la que viven cuatro informes: eso se planifica, no se improvisa un martes.

Lo que hay que decir antes de que lo preguntenQue yo lo haya encontrado no lo convierte en mío. Lo que hice fue medirlo y escribirlo donde se pueda decidir.

Seis millones de filas intermedias para un indicador

Una app de gestión de personas llevaba tres meses sin recargar. El bloque de clima laboral leía cinco tablas de encuestas completas.

412.836
encuestas leídas enteras
4,9 M
respuestas
6,1 M
filas intermedias
3
pestañas con la misma cadena
  • Se arregló filtrando en el origen, sin cambiar la lógica: el indicador da lo mismo, pero ya no se traen cinco tablas enteras para agregarlas después.
  • Detrás apareció el bloqueo real: un conector REST apunta a una versión antigua del ERP y devuelve 401. Estaba contenido con ErrorMode = 0, es decir, el script seguía adelante como si nada.

Un error silenciado con ErrorMode = 0 es una decisión, no un accidente. Lo que hice fue dejarlo visible con una tabla de estado de carga, para que la próxima vez se note.

Lo que hay que decir antes de que lo preguntenMigrar esa conexión mueve datos de varios informes. Sigue pendiente de decisión, y está escrito así.

Una llave rota que ponía septiembre en cero

El informe de rotación mostraba el mes en curso sin un solo retiro. Nadie lo había reportado: parecía un mes bueno.

0 → 13.546
retiros asociados
0 → 1.125
retiros en el mes en curso
554.349
filas persona-mes del modelo
  • La llave persona-mes estaba mal construida y dejaba los retiros sin asociar. Arreglada y verificada en la copia de trabajo.
  • Sobre ese panel construí después el modelo de riesgo de renuncia voluntaria: 18.157 episodios de empleo, 6.404 renuncias voluntarias, 86 variables.

El origen reportaba 7.048 «renuncias voluntarias». 325 eran traslados entre sociedades del mismo grupo: la persona nunca se fue. Cambiar la llave del episodio de número de nómina a cédula lo corrigió, y eso cambia todas las cifras que van detrás.

Lo que hay que decir antes de que lo preguntenLa app publicada sigue con el dato viejo a propósito: arreglarla sube números que alguien está mirando, y eso se avisa antes, no después.

Un estado de resultados que cuadra al peso

Un área llevaba su P&G en Excel, con su formato, sus negritas y sus totales desplegables. Querían verlo en Qlik sin perder eso.

18 de 18
filas cuadradas al peso
7
columnas: real, presupuesto y año anterior
0
importes en «sin clasificar»
  • La clasificación de cuentas se lee de su propio Excel por búsqueda directa de la cuenta. La cascada de mapeos que ya existía acertaba el grupo en 43 de 131 cuentas — y no se tocó, porque de ella dependen otras dos hojas.
  • Comparado contra su Excel del mes, en real y en presupuesto, fila por fila.

Dos discrepancias quedaron abiertas y dichas: su Excel infla el presupuesto en 9.981.369 por dos filas duplicadas en Seguros, y las toneladas reales van un mes atrasadas.

Lo que hay que decir antes de que lo preguntenCuadrar contra el Excel del área no es lo mismo que cuadrar contra la contabilidad. Lo que está verificado es lo primero.
Método

Cómo trabajo un informe ajeno

Casi ninguno de los 23 informes lo escribí yo. Llegaron hechos, con el contexto en la cabeza de quien se fue. Esto es lo que monté para no volver a reconstruirlo cada vez.

Un repositorio por informe, no una carpeta de respaldos

Cada informe tiene su ficha de contexto, su script troceado por pestañas y versionado, y un registro de quién pidió qué y por qué. Un «devuelve lo que pidió Comercial el mes pasado» es un git revert, no una tarde perdida.

Nunca se escribe en la publicada

Se trabaja en una copia, se compara contra la publicada y se publica cuando los números cuadran. Las apps de respaldo están marcadas y las herramientas se niegan a escribir en ellas.

Línea base antes y después

Antes de tocar nada, tomo el valor de todas las medidas de la app. Después del cambio, las vuelvo a tomar y comparo. Lo que no aparece en esa comparación no está verificado, y se dice.

Automatizo lo que se repite

Node.js contra la Engine API por websocket para leer y escribir script, hojas y objetos, y contra el Repository Service por REST para lo administrativo. El navegador solo se abre cuando la pregunta es «cómo se ve». Las capturas de la demo de arriba salieron de ahí.

El porqué se escribe

Los mensajes de commit llevan la razón, no el resumen del diff. Cada informe tiene una lista de lo que está a medias y con qué diagnóstico. Eso es lo que hace que una petición cueste una hora y no un día.

Capacidades

Qué sé hacer, y con qué lo respaldo

Cada línea con dónde está la prueba. Lo que no puedo demostrar va en la lista de abajo, no escondido entre las demás.

Qlik Sense EnterpriseQlik Sense Enterprise on Windows, ~4 años. 23 informes en producción a mi cargo: los mantengo, los optimizo y respondo por sus números.
Conexión a orígenes de datosODBC contra el ERP y contra la base de nómina; conectores REST; carpetas de red; Excel y SharePoint / Office 365; Google Drive; SAP OData.
ModeladoDe 8 claves sintéticas a 3 en la app más grande, con las tres restantes documentadas y explicadas. La demo de arriba es una estrella limpia: 0 sintéticas, 0 lazos circulares.
Scripting y QVDApps extractoras que dejan QVD para otros informes; una eliminó 23 aperturas de un Excel que costaban ~21 s cada una. Catálogo de 419 QVD de la biblioteca leyendo solo cabeceras.
Set analysisPresupuesto y real separados sobre la misma tabla de hechos; comparaciones interanuales recortadas por mes de corte; P() y E() cuando hacen falta.
Diseño de tablerosLas cuatro hojas de la demo. También una hoja que reproduce el formato exacto del Excel de un área, porque ahí la usabilidad era esa.
NegocioRotación, nómina, clima laboral, P&G, cartera, logística y comercio exterior. La mayoría de los errores que he encontrado eran de negocio, no de Qlik.
AutomatizaciónNode.js contra la Engine API y el Repository Service: escritura de script, hojas y objetos, y líneas base de todas las medidas de una app para comparar antes y después.
Datos más allá de QlikSQL sobre tablas de millones de filas. Python para modelado: un modelo de riesgo de renuncia voluntaria sobre un panel persona-mes de 554.349 filas y 86 variables.

Lo que no tengo

  • No he administrado SQL Server ni MySQL en producción. Trabajo a diario con SQL sobre PostgreSQL y SQLite, y el que escribo es portable.
  • No he trabajado en un equipo con Scrum formal. Mis ciclos los marca el área que pide, con registro de cambios por petición.
  • No tengo certificación oficial de Qlik ni examen de inglés. El nivel de inglés es B2 real.

Qlik Sense

  • Script de carga: LOAD, RESIDENT, JOIN, CONCATENATE, MAPPING/ApplyMap, preceding loads, control statements
  • Set analysis: identificadores, modificadores, P() y E(), TOTAL, Aggr
  • Modelado: estrella, calendario maestro, claves sintéticas, lazos circulares
  • QVD: extractoras, carga incremental, catálogo por cabeceras
  • Engine API (enigma.js) y Repository Service (QRS) desde Node.js
  • Variables de app, colores por expresión, tablas dinámicas, medidores

Datos

  • SQL (PostgreSQL, SQLite) sobre tablas de hechos de millones de filas
  • ODBC y conectores REST contra ERP y sistemas propios
  • Python: pandas, scikit-learn, statsmodels, lifelines, LightGBM, SHAP
  • Análisis de supervivencia en tiempo discreto, validación y caza de fugas de datos
  • Excel, que sigue siendo donde el negocio abre las cosas

Desarrollo

  • JavaScript y Node.js
  • React (Vite, Tailwind)
  • Cloudflare Workers, D1, KV, R2
  • Git como documentación, no solo como respaldo

Cierre

Lo que no hay en esta página

  • Ninguna captura con datos reales de mi empresa. Las de la demo son de una app que construí con datos inventados, y las de los informes reales van con los nombres sustituidos y los importes escalados.
  • Ninguna cifra sin una medición detrás. Las que aparecen salieron de contar filas, cronometrar recargas o comparar líneas base.
  • Ningún certificado que no tenga. Mi inglés es B2 real, sin examen oficial.
  • Los repositorios del trabajo son privados. Puedo recorrer cualquiera de ellos en vivo en una llamada.